Regressão Logística na Tese de Gestão: Exemplo Passo a Passo (2026)
O orientador disse “isto é uma variável binária, precisa de regressão logística” — e agora? Muitas teses de Gestão medem um resultado que só tem duas categorias: o colaborador saiu ou ficou, o cliente cancelou ou renovou, a empresa obteve o financiamento ou não. Para este tipo de variável dependente, a regressão linear não serve — os pressupostos de normalidade e de variância constante deixam de fazer sentido quando o resultado só pode valer 0 ou 1. Este artigo mostra, com um exemplo fictício de tese de Gestão de Recursos Humanos, como estruturar uma regressão logística binária do início ao fim: a verificação de pressupostos, o ajustamento do modelo, a leitura dos odds ratios e a frase exata para o capítulo de resultados.
1. Quando a tese de Gestão precisa de regressão logística
A regressão logística binária aplica-se sempre que a variável dependente da tese de Gestão distingue apenas dois estados: o colaborador manteve-se ou saiu da empresa, o cliente renovou o contrato ou não, o projeto obteve financiamento ou foi recusado, a PME sobreviveu aos primeiros cinco anos ou encerrou. É um dos desenhos mais comuns em dissertações de Gestão de Recursos Humanos, Marketing (previsão de churn) e Finanças Empresariais (previsão de incumprimento), precisamente porque as decisões de gestão que mais interessam à prática — reter, converter, financiar — são, na sua essência, decisões binárias.
Nota metodológica: se a variável dependente tiver mais de duas categorias não ordenadas (por exemplo, três tipos de saída — despedimento, demissão voluntária, reforma), o modelo correto é a regressão logística multinomial, não a binária; se as categorias forem ordenadas (baixo/médio/alto risco), aplica-se a regressão logística ordinal. Este artigo trata apenas do caso binário, que é o mais frequente em teses de mestrado em Gestão. Para uma visão mais ampla de como organizar dados e modelos econométricos numa dissertação de Gestão ou Economia, veja também o recurso sobre como estruturar dados e modelos numa tese de Gestão e Economia.
2. Pressupostos e dimensão da amostra
A regressão logística não exige normalidade nem homocedasticidade dos resíduos — ao contrário da regressão linear — mas tem três condições próprias que a tese precisa de verificar e reportar explicitamente:
- Independência das observações: cada caso (colaborador, cliente, empresa) só pode entrar uma vez na base de dados.
- Ausência de multicolinearidade severa entre preditores: avaliada com o Fator de Inflação da Variância (VIF); valores de VIF acima de 5 (alguns autores usam o limiar mais conservador de 10) indicam que dois ou mais preditores estão a medir essencialmente a mesma coisa, o que torna os odds ratios instáveis.
- Dimensão da amostra em função dos eventos, não apenas dos casos totais: a heurística mais citada na literatura metodológica — Peduzzi, Concato, Kemper, Holford e Feinstein (1996) — recomenda pelo menos 10 eventos por preditor (EPV, do inglês events per variable). “Eventos” refere-se à categoria menos frequente da variável dependente: se apenas 30% dos colaboradores da amostra saíram da empresa, é esse subgrupo — não a amostra total — que entra no cálculo do EPV.
Comentário: é aqui que muitas teses de Gestão erram sem perceber — uma amostra de 300 colaboradores parece grande, mas se apenas 20 saíram da empresa no período em estudo, o EPV disponível para 4 preditores é de apenas 5 (20 ÷ 4), bem abaixo do mínimo recomendado. A solução nesse caso não é “usar a amostra na mesma” — é reduzir o número de preditores, alargar o período de recolha de dados ou reconhecer explicitamente a limitação na secção correspondente da tese. Para o cálculo equivalente em regressão linear (baseado no total de casos, não em eventos), veja o artigo sobre quantos casos precisa por variável na regressão da tese.
3. Exemplo passo a passo: prever a saída voluntária de colaboradores
Os dados que se seguem são inteiramente fictícios e ilustrativos, construídos apenas para mostrar a lógica do procedimento — nunca copie estes números para a sua própria tese.
Cenário ilustrativo: uma dissertação de Gestão de Recursos Humanos investiga que fatores estão associados à saída voluntária de colaboradores de uma empresa de serviços portuguesa, com base num levantamento interno de 150 colaboradores, dos quais 45 (30%) saíram voluntariamente nos 12 meses seguintes à recolha de dados.
Variável dependente (ilustrativa): Saída voluntária (0 = permaneceu, 1 = saiu voluntariamente nos 12 meses seguintes).
Preditores (ilustrativos):
- Satisfação no trabalho (escala de 1 a 5)
- Perceção de progressão de carreira (escala de 1 a 5)
- Antiguidade na empresa (anos)
- Salário relativo à média de mercado para a função (%, 100% = igual à média)
Comentário: com 45 eventos (saídas) e 4 preditores, o EPV ilustrativo deste cenário é de 11,25 (45 ÷ 4) — acima do limiar de 10 recomendado por Peduzzi et al., o que justifica, na secção de metodologia, a afirmação de que a amostra tem dimensão suficiente para os quatro preditores planeados. Este é exatamente o tipo de frase que um júri de Gestão procura na secção de amostra: não basta dizer “a amostra é adequada” — é preciso mostrar o cálculo.
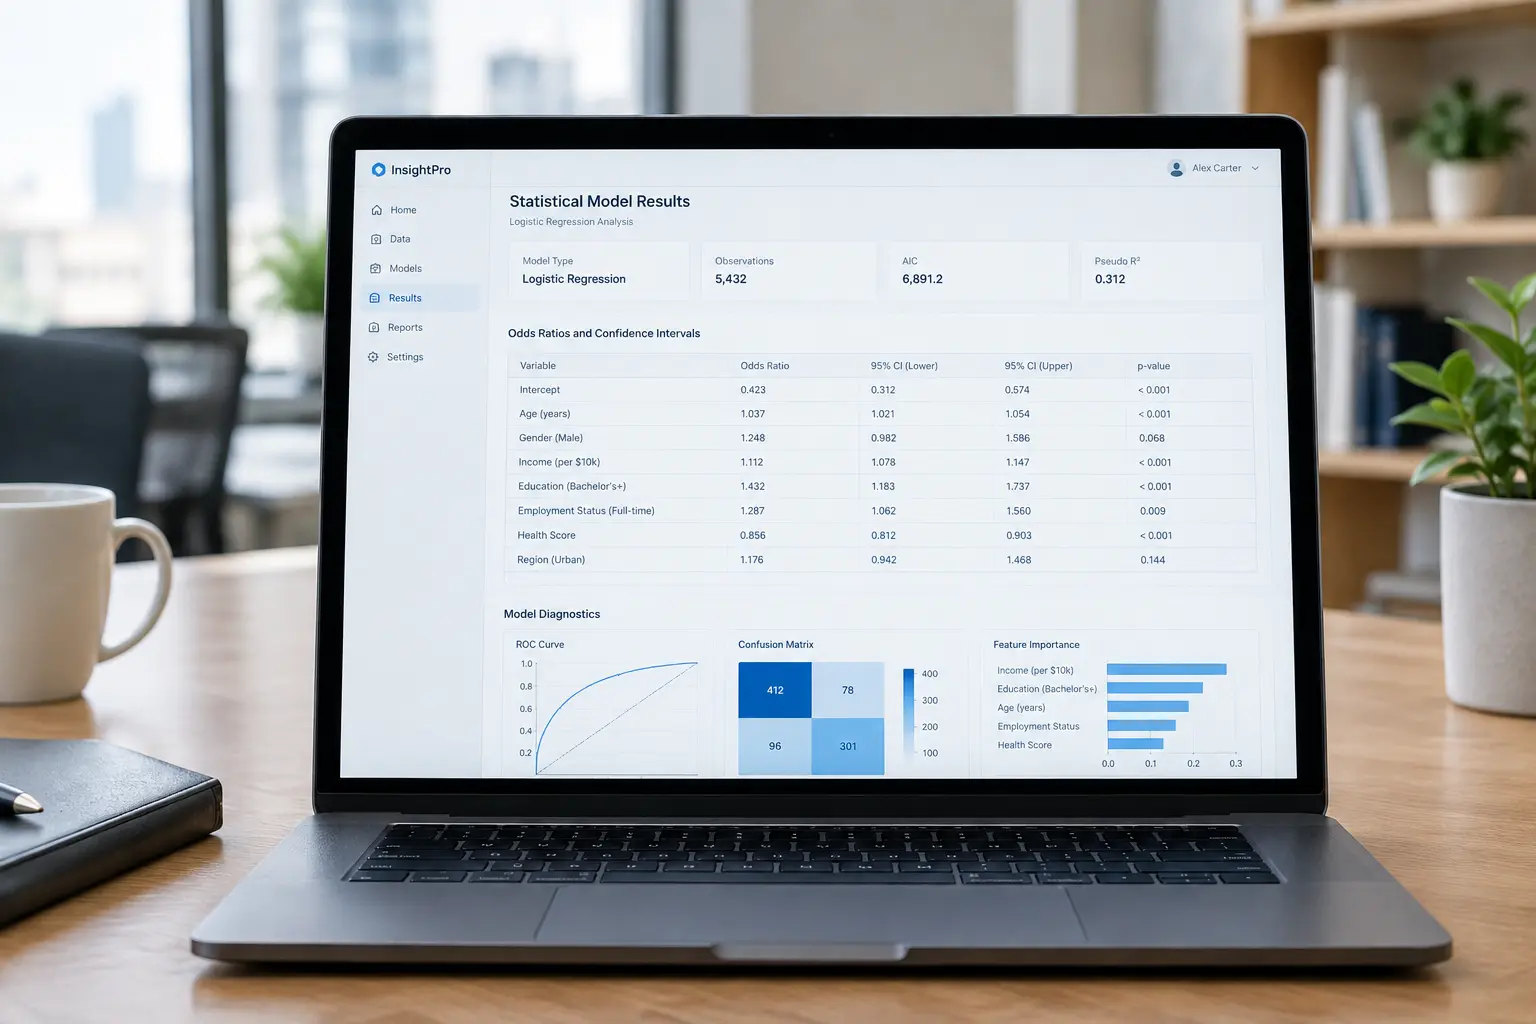
Procedimento no SPSS/Jamovi: Regressão → Binária Logística; variável dependente = saída voluntária; método = Enter (introduzir todos os preditores em bloco único, já que o modelo é confirmatório e não exploratório); solicitar o teste de Hosmer-Lemeshow, os intervalos de confiança a 95% para Exp(B) e a tabela de classificação.
4. Avaliar o ajustamento do modelo
Antes de interpretar qualquer coeficiente, a tese tem de mostrar que o modelo, no seu conjunto, ajusta bem os dados. Três indicadores fazem esse trabalho, e os três têm de aparecer juntos no capítulo de resultados:
| Indicador | O que mostra | Valor ilustrativo |
|---|---|---|
| Teste de Hosmer-Lemeshow | Se o modelo se ajusta bem aos dados (um p não significativo, > 0,05, é o resultado desejado — o oposto da lógica habitual de outros testes) | χ²(8) = 5,84; p = 0,67 |
| Pseudo-R² de Nagelkerke | A proporção de variação explicada, numa escala aproximável (mas não idêntica) à do R² da regressão linear | 0,34 |
| Tabela de classificação | A percentagem de casos corretamente classificados pelo modelo, incluindo sensibilidade e especificidade | 78% global (117/150); sensibilidade 62% (28/45); especificidade 85% (89/105) |
Comentário: repare que a sensibilidade (a capacidade de identificar corretamente quem sai) é mais baixa do que a especificidade (a capacidade de identificar corretamente quem fica) — um padrão comum quando a categoria de interesse (saída) é a minoritária na amostra. Reportar apenas a percentagem global de classificação, sem separar sensibilidade e especificidade, esconde exatamente esta assimetria, e é um dos erros que os júris de Gestão mais assinalam.
5. Interpretar e reportar os odds ratios
O coeficiente B da regressão logística não se lê em unidades da variável dependente — lê-se através do seu exponencial, Exp(B), que é o odds ratio: quanto o rácio de probabilidades do evento (sair da empresa) se multiplica por cada unidade de aumento no preditor, mantendo os restantes preditores constantes.
| Preditor | Exp(B) ilustrativo | Leitura |
|---|---|---|
| Satisfação no trabalho | 0,62 | Cada ponto adicional na escala de satisfação reduz o rácio de probabilidade de saída em cerca de 38% |
| Progressão de carreira percebida | 0,54 | O preditor com maior peso relativo no modelo ilustrativo |
| Antiguidade (anos) | 0,93 | Efeito pequeno mas na direção esperada |
| Salário relativo ao mercado | 0,97 | Não significativo no modelo ilustrativo (IC 95% inclui 1) |
Comentário: um Exp(B) abaixo de 1 significa que o preditor reduz a probabilidade do evento; acima de 1, que a aumenta. O sinal a verificar sempre antes de interpretar um resultado como significativo é se o intervalo de confiança a 95% do Exp(B) inclui o valor 1 — se incluir, como no caso ilustrativo do salário relativo, o efeito não é estatisticamente distinguível de ausência de efeito, e a tese não deve tratá-lo como um achado, apenas mencioná-lo como não significativo.
Frase-modelo para o capítulo de resultados: “A satisfação no trabalho associou-se a uma redução de 38% no rácio de probabilidade de saída voluntária (Exp(B) = 0,62; IC 95% [0,44; 0,87]; p = 0,006), controlando para antiguidade, progressão de carreira percebida e salário relativo ao mercado.” Esta frase junta os três elementos que um júri de Gestão espera sempre: o odds ratio, o intervalo de confiança e a referência explícita ao controlo dos restantes preditores.
6. Erros que invalidam a regressão logística na tese
Três erros recorrentes em teses de Gestão com regressão logística: (1) interpretar o Exp(B) como se fosse um coeficiente de regressão linear — dizer “por cada ponto de satisfação, a saída desce 0,62” está errado; o correto é falar em rácio de probabilidades; (2) reportar apenas o pseudo-R² sem o teste de Hosmer-Lemeshow nem a tabela de classificação, escondendo se o modelo realmente se ajusta aos dados; (3) incluir preditores fortemente correlacionados entre si (por exemplo, satisfação no trabalho e satisfação com o superior direto, quando medem construtos quase idênticos) sem verificar o VIF, o que infla artificialmente os erros-padrão e pode tornar um preditor genuinamente relevante estatisticamente não significativo só por colinearidade. Um quarto erro, menos discutido mas igualmente grave, é reportar o modelo final sem indicar o método de introdução dos preditores (Enter, Forward ou Backward); num modelo confirmatório como o deste exemplo, em que a tese parte de hipóteses definidas a priori, o método Enter é o que preserva a lógica confirmatória — usar um método stepwise automático transformaria o estudo em exploratório sem que isso fosse assumido no capítulo de metodologia. Para o desenho da variável dummy quando um dos preditores é categórico com mais de duas categorias (por exemplo, departamento da empresa), veja o artigo sobre variáveis dummy e categoria de referência na regressão, e para o texto completo do projeto de investigação que normalmente antecede este capítulo, o guia sobre como escrever o projeto de investigação de uma tese de Gestão.
Perguntas Frequentes
Regressão logística ou regressão linear: como escolher na tese de Gestão?
A escolha depende inteiramente da natureza da variável dependente: se for contínua (por exemplo, o volume de vendas em euros), usa-se regressão linear; se for binária (saiu/ficou, comprou/não comprou), usa-se regressão logística binária. Nunca se decide pelo tipo de preditores — apenas pelo tipo da variável a explicar.
Quantos casos são necessários para uma regressão logística na tese?
A heurística mais citada (Peduzzi et al., 1996) recomenda pelo menos 10 eventos por preditor, em que “eventos” é a categoria menos frequente da variável dependente, não o total de casos da amostra. Uma amostra de 300 pessoas com apenas 20 eventos oferece um EPV muito mais baixo do que a mesma amostra sugere à primeira vista.
O que significa um Exp(B) igual a 1 na regressão logística?
Um Exp(B) de exatamente 1 significa que o preditor não altera o rácio de probabilidade do evento. Na prática, o que importa reportar é se o intervalo de confiança a 95% do Exp(B) inclui o valor 1 — se incluir, o efeito não é estatisticamente significativo, independentemente de o valor pontual do Exp(B) ser inferior ou superior a 1.
Estruture o capítulo de resultados da sua tese de Gestão com o Tesify
O Tesify ajuda a organizar o capítulo de metodologia e resultados da sua tese de Gestão, com estrutura de tabelas, redação da interpretação estatística e citações automáticas em APA 7.
Escreve a tua tese ou TCC com IA
Editor inteligente, bibliografia automática (APA e ABNT) e verificação antiplágio num só sítio. Mais de 9.000 estudantes já escrevem em metade do tempo.