Como Apresentar os Resultados de uma Tese Quantitativa em Gestão: Tabelas, Gráficos e Testes
Ter os números certos não chega numa tese quantitativa de Gestão — o capítulo de resultados só convence o júri quando os dados estão organizados na sequência certa, nas tabelas certas, e acompanhados da interpretação que liga cada teste estatístico de volta às hipóteses do estudo. Este guia percorre a ordem, o formato e os erros mais comuns na apresentação de resultados quantitativos numa tese de Gestão.
A ordem que o júri espera encontrar
Um capítulo de resultados bem estruturado segue uma sequência lógica que vai do geral para o específico: primeiro, a caracterização da amostra (perfil demográfico ou empresarial dos respondentes ou casos); depois, as estatísticas descritivas das variáveis principais (médias, desvios-padrão, frequências); em seguida, os testes de validação dos instrumentos, quando aplicável (fiabilidade das escalas, análise fatorial); e só depois disso os testes inferenciais que respondem diretamente a cada hipótese, organizados hipótese a hipótese, na mesma ordem em que foram apresentadas no capítulo de metodologia. Inverter esta ordem — por exemplo, apresentar os testes de hipóteses antes de caracterizar a amostra — obriga o leitor a voltar atrás constantemente para perceber o contexto dos números.
Como apresentar a caracterização da amostra
A tabela de caracterização da amostra deve incluir as variáveis demográficas ou organizacionais relevantes (idade, género, antiguidade, dimensão da empresa, setor) com frequências absolutas e percentagens, nunca apenas uma delas. Uma boa prática é comparar a estrutura da amostra com a população-alvo, quando essa informação estiver disponível, para que o leitor possa avaliar até que ponto a amostra é representativa — por exemplo, comparando a distribuição por setor da amostra com dados do INE sobre a distribuição sectorial das PME em Portugal.
Estatísticas descritivas: que tabela usar
Para variáveis contínuas (escalas Likert agregadas, indicadores financeiros), a tabela de estatísticas descritivas deve reportar a média, o desvio-padrão, o mínimo e o máximo, e, quando relevante para a escolha do teste seguinte, a assimetria (skewness) e a curtose, que indicam se a distribuição se afasta da normalidade. Para variáveis categóricas, use tabelas de frequência com percentagens. Evite misturar os dois tipos de variável na mesma tabela sem clareza sobre qual medida se aplica a cada uma — uma tabela que reporta a “média” de uma variável categórica como o setor de atividade não faz sentido estatístico e é um erro que salta à vista de qualquer júri com formação quantitativa.
Como escolher entre tabela e gráfico
A regra prática mais útil: use tabelas quando o leitor precisa de valores exatos (coeficientes de regressão, médias específicas, p-values), e use gráficos quando o objetivo é comunicar um padrão ou uma comparação visual (a evolução de uma variável ao longo de grupos, a distribuição de respostas numa escala). Um gráfico de barras que compara a média de satisfação entre três departamentos comunica a diferença mais rapidamente do que uma tabela com os mesmos três números; mas o valor exato do teste de significância dessa diferença pertence sempre a uma tabela, nunca apenas a uma legenda de gráfico.
Que tipo de gráfico usar para cada tipo de comparação
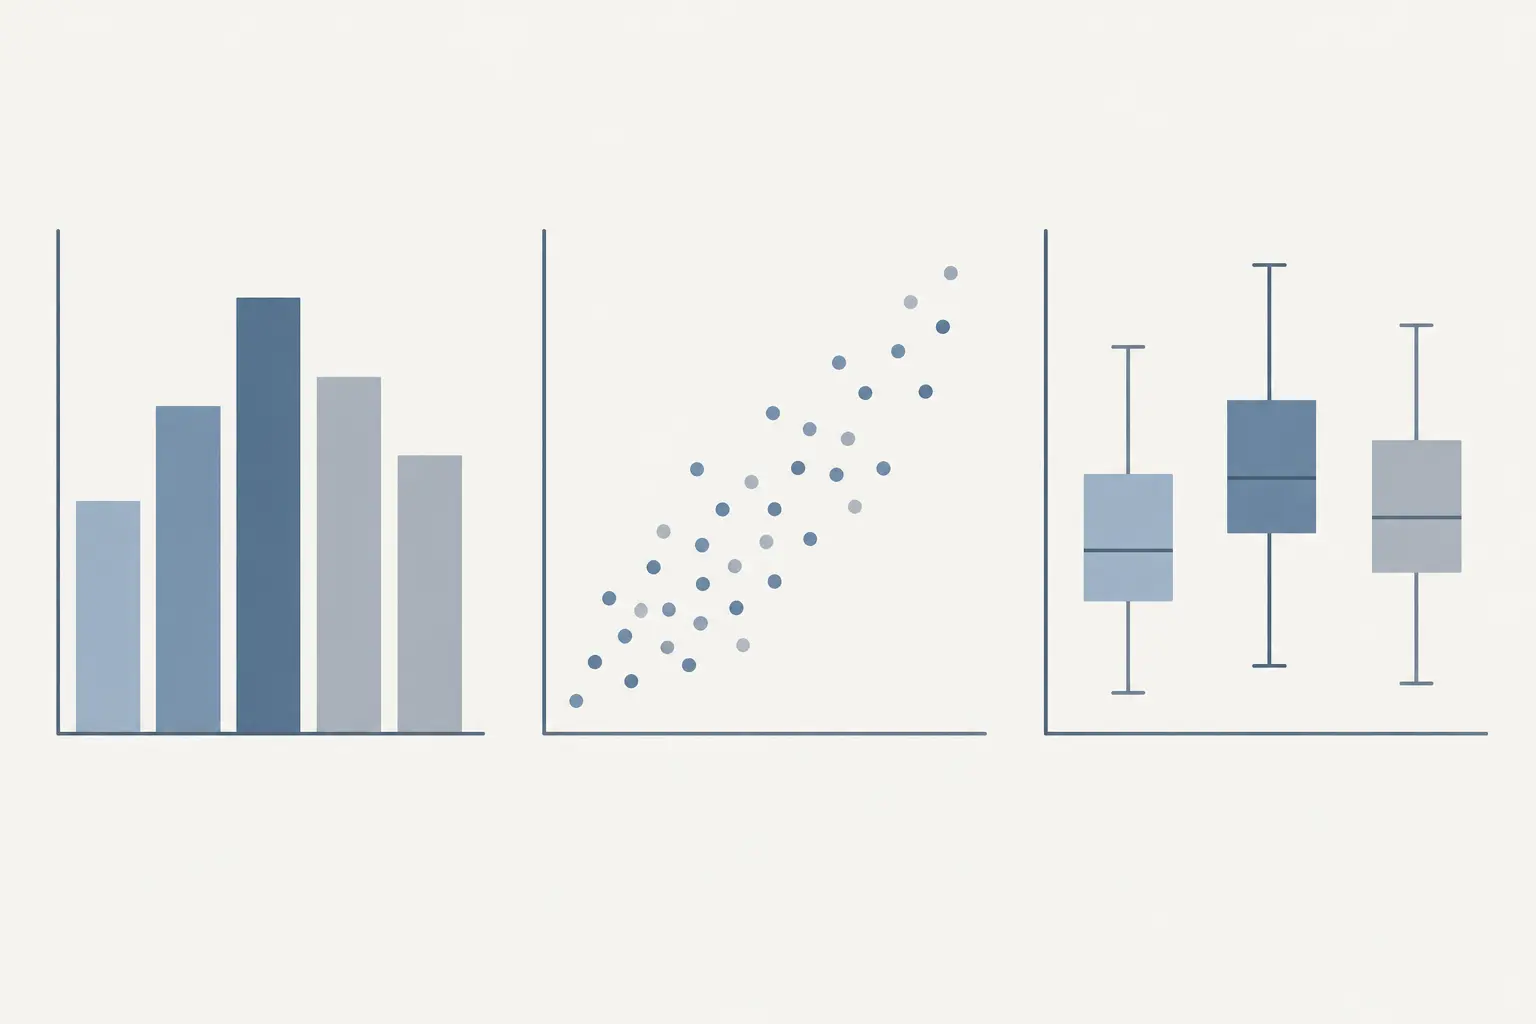
Nem todos os gráficos comunicam a mesma coisa, e escolher o tipo errado é um erro visual tão problemático quanto um erro estatístico. Um gráfico de barras é adequado para comparar médias entre grupos categóricos (por exemplo, satisfação média por departamento); um gráfico de dispersão (scatter plot) é o formato correto para mostrar a relação entre duas variáveis contínuas, muitas vezes com uma linha de tendência sobreposta; um box plot é particularmente útil quando o objetivo é mostrar não só a tendência central mas também a dispersão e os valores atípicos (outliers) de uma variável entre grupos; e um gráfico de linhas serve para mostrar a evolução de uma variável ao longo do tempo, quando o desenho do estudo é longitudinal. Usar um gráfico de barras para representar uma correlação entre duas variáveis contínuas, por exemplo, é um erro comum que distorce visualmente a natureza da relação estudada.
Que teste estatístico corresponde a cada hipótese
| Tipo de hipótese | Teste habitual |
|---|---|
| Comparar médias entre dois grupos | Teste t de Student (ou Mann-Whitney se a normalidade não se verificar) |
| Comparar médias entre três ou mais grupos | ANOVA (ou Kruskal-Wallis para dados não paramétricos) |
| Associação entre duas variáveis categóricas | Teste do qui-quadrado |
| Relação entre uma variável dependente contínua e vários preditores | Regressão linear múltipla |
| Relação entre uma variável dependente binária e vários preditores | Regressão logística binária |
| Correlação entre duas variáveis contínuas | Correlação de Pearson (ou Spearman para dados não paramétricos) |
Antes de aplicar qualquer um destes testes, verifique e reporte explicitamente os pressupostos que lhes correspondem (normalidade para testes paramétricos, homogeneidade de variâncias para ANOVA) — um teste aplicado sem verificar os pressupostos é uma das objeções mais previsíveis numa defesa de tese quantitativa em Gestão.
Cuidado com o eixo Y em gráficos de barras
Um erro visual frequente, e que um júri atento identifica de imediato, é truncar o eixo Y de um gráfico de barras para exagerar visualmente uma diferença pequena entre grupos — por exemplo, iniciar o eixo em 3,5 numa escala de 1 a 5, o que faz uma diferença de 0,2 pontos parecer proporcionalmente enorme. Salvo justificação estatística explícita, o eixo Y de um gráfico de barras que representa uma escala Likert ou um indicador com limites naturais deve começar em zero (ou no limite mínimo da escala), para que a comparação visual seja proporcional à diferença real entre os grupos.
Como reportar um teste de hipótese, frase a frase
Cada teste de hipótese reportado no capítulo de resultados deve seguir uma estrutura consistente: (1) relembrar a hipótese que está a ser testada, (2) apresentar a estatística de teste com o respetivo valor de p, (3) indicar se a hipótese foi confirmada ou rejeitada, e (4) reportar a magnitude do efeito (por exemplo, d de Cohen para um teste t, ou R² para uma regressão), não apenas a significância. Uma frase-modelo, com valores ilustrativos: “A Hipótese 2 previa que colaboradores com maior perceção de progressão de carreira reportariam maior satisfação no trabalho. O teste t confirmou uma diferença significativa entre os grupos (t(148) = 3,42; p = 0,001; d de Cohen = 0,56), suportando a Hipótese 2 com um efeito de magnitude moderada.”
Como apresentar resultados que não confirmam a hipótese
Um resultado não significativo não é um resultado a esconder ou a minimizar — é um resultado a reportar com o mesmo rigor de um resultado significativo. Reporte a estatística de teste e o p-value exatamente como faria para um resultado confirmado, e reserve a discussão sobre porque a hipótese pode não se ter confirmado (amostra pequena, medição imperfeita da variável, ou a relação teórica simplesmente não se verificar no contexto estudado) para o capítulo de discussão, não para o capítulo de resultados, que deve manter-se descritivo e livre de interpretação especulativa.
Como formatar uma tabela de regressão múltipla
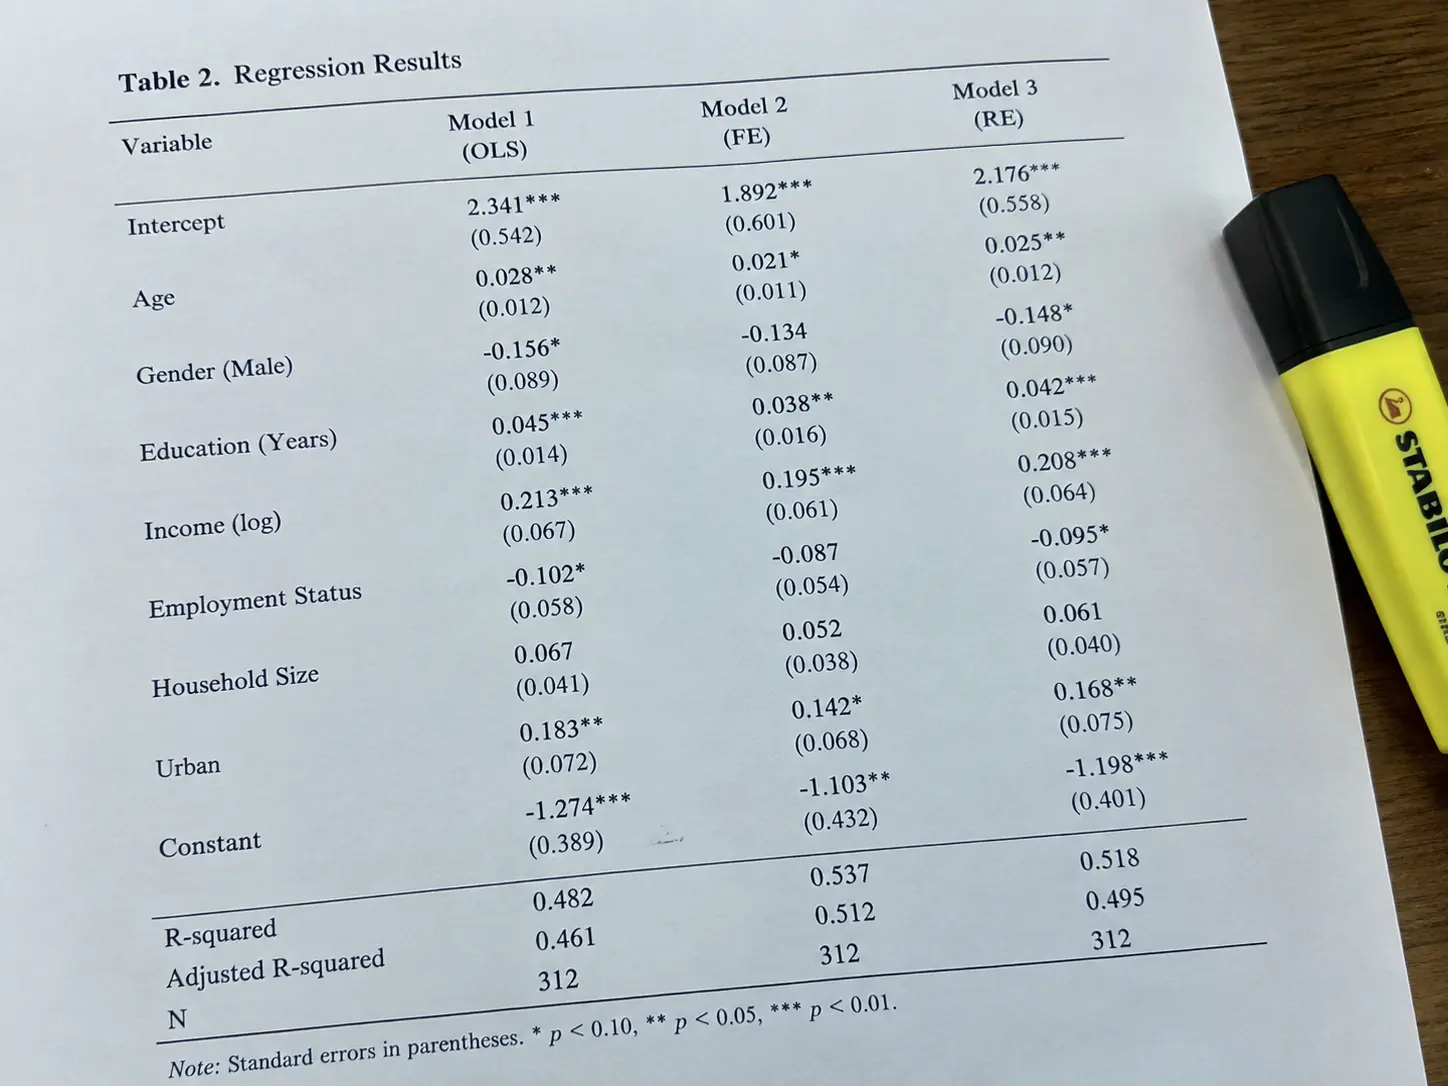
Uma tabela de regressão múltipla bem formatada organiza os preditores em linhas e reporta, para cada um, o coeficiente não padronizado (B), o erro-padrão, o coeficiente padronizado (Beta) quando os preditores estão em escalas diferentes, e o valor de p, com asteriscos de significância convencionais (* p < 0,05; ** p < 0,01; *** p < 0,001) explicados numa nota de rodapé. No final da tabela, reporte sempre o R² ajustado do modelo e a estatística F com o respetivo p-value, que testam a significância conjunta do modelo, distinta da significância de cada preditor individual. Quando compara vários modelos sucessivos (por exemplo, um modelo apenas com variáveis de controlo e um segundo modelo com o preditor principal adicionado), apresente-os lado a lado na mesma tabela, com uma coluna para cada modelo, e reporte a variação do R² entre eles.
Um exemplo de sequência completa para uma hipótese
Considere, a título ilustrativo, uma tese que testa se a perceção de justiça organizacional está associada à intenção de saída dos colaboradores. A sequência de apresentação seria: primeiro, a tabela de estatísticas descritivas das duas variáveis (média e desvio-padrão da escala de justiça organizacional e da escala de intenção de saída); depois, a tabela de correlação de Pearson entre as duas variáveis, com o coeficiente e o p-value; e por fim, se o desenho da tese o justificar, uma tabela de regressão linear com a intenção de saída como variável dependente e a justiça organizacional como preditor principal, controlando para variáveis demográficas relevantes (antiguidade, idade). Cada uma destas três tabelas responde a uma pergunta ligeiramente diferente, e apresentá-las nesta ordem — descritiva, depois relacional, depois explicativa — é o que torna a progressão lógica e fácil de seguir para o júri.
Erros mais comuns nesta fase
- Reportar apenas o p-value, sem a magnitude do efeito. Um resultado estatisticamente significativo numa amostra grande pode ter um efeito trivial — reporte sempre uma medida de magnitude (d de Cohen, R², eta quadrado) junto do p-value.
- Usar gráficos para valores que exigem precisão. Um coeficiente de regressão ou um p-value pertence a uma tabela, nunca apenas a uma legenda de gráfico difícil de ler com precisão.
- Não verificar nem reportar os pressupostos do teste escolhido. Aplicar um teste paramétrico sem verificar a normalidade é uma das objeções mais previsíveis numa defesa de Gestão quantitativa.
- Misturar interpretação com descrição no capítulo de resultados. O capítulo de resultados descreve o que os testes mostram; a interpretação teórica pertence ao capítulo de discussão.
- Formatar tabelas de forma inconsistente entre si. Use o mesmo número de casas decimais e a mesma convenção de asteriscos de significância (*, **, ***) em todas as tabelas do capítulo.
Perguntas Frequentes
Devo apresentar todos os resultados, mesmo os que não confirmam nenhuma hipótese?
Sim — omitir resultados não significativos distorce o quadro geral do estudo e é uma prática que compromete a integridade científica do trabalho; reporte-os com o mesmo rigor dos resultados confirmados.
Quantas casas decimais devo usar nas tabelas de resultados?
Duas ou três casas decimais são o padrão mais comum em teses de Gestão, aplicadas de forma consistente em todas as tabelas do capítulo — evite variar o número de casas decimais entre tabelas semelhantes.
Posso usar apenas gráficos e dispensar as tabelas de resultados?
Não é recomendável — os gráficos comunicam padrões visuais, mas os valores exatos (coeficientes, p-values, intervalos de confiança) que o júri precisa para avaliar o rigor do estudo pertencem sempre a uma tabela.
O que fazer quando os dados não cumprem os pressupostos de um teste paramétrico?
Use a alternativa não paramétrica correspondente (Mann-Whitney em vez do teste t, Kruskal-Wallis em vez de ANOVA, correlação de Spearman em vez de Pearson) e reporte explicitamente porque essa alternativa foi necessária.
Como devo organizar os resultados quando tenho várias hipóteses relacionadas?
Apresente-as na mesma ordem em que foram formuladas no capítulo de metodologia, uma a uma, com um subtítulo claro para cada hipótese, para que o leitor consiga acompanhar facilmente a correspondência entre hipótese e resultado.
Devo reportar o R² ajustado ou o R² simples numa regressão múltipla?
Reporte o R² ajustado como medida principal, porque corrige o facto de o R² simples aumentar artificialmente à medida que se adicionam mais preditores ao modelo, mesmo que estes não contribuam de forma real para a explicação da variável dependente.
Como o Tesify ajuda nesta fase
O Tesify ajuda-o a planear a estrutura do capítulo de resultados de uma tese quantitativa de Gestão, com a sequência de tabelas organizada hipótese a hipótese — a análise estatística em si e a formatação final das tabelas continuam a ser inteiramente suas. Já apoiou mais de 9.000 estudantes em mais de 15.000 capítulos, e a tese continua a ser 100% escrita por si.
Para transformar estes resultados num capítulo de discussão sólido, veja o guia sobre como escrever a discussão de resultados numa dissertação em Gestão. Para construir um título que o júri aceita, veja os 30 exemplos de títulos de tese em Gestão de Recursos Humanos. Para negociar o acesso a dados quando o estudo é feito dentro da própria empresa, consulte o guia sobre tese de Gestão sobre a própria empresa.
Escreve a tua tese ou TCC com IA
Editor inteligente, bibliografia automática (APA e ABNT) e verificação antiplágio num só sítio. Mais de 9.000 estudantes já escrevem em metade do tempo.